Appearance
检索操作相关技术名词part2
本篇文章继续介绍和检索操作相关的技术名词。
1. Small-to-Big Retrieval
Small-to-Big Retrieval 的核心意思不难,就是 “先小后大” 的检索策略。
整体流程差不多就是:
- 向量检索找到小块
- 按 parent_id、section_id、邻接关系,把大块取出来
1-1. 基本概念
举个例子,用户问:
病假需要提供什么材料先检索到小块:
病假超过 3 天,需额外提供医院开具的诊断证明。然后再根据 parent_id、section_id 等,发现:这句属于 病假管理 这一节
它前面还有申请规则,后面还有补交说明,于是把整段 病假管理 一起取回来。
它特别适合这些场景:
- 文档很长
- 一篇文档里包含多个主题
- 用户问题问得比较细
- 既想召回准,又不想丢掉上下文
优点是:
- 比直接检索大块更精准
- 比只返回小块更完整
- 对长文档场景很有用
这就有点类似于我们要引用书里面的话作为答案给别人,你不会一上来就把整本书都翻给别人,也不会只截一句话。更合理的做法是先通过一句关键内容定位到那一页,再把那一页或者那一节一起拿出来看。
所以 Small-to-Big Retrieval 本质上就是:先小范围命中,再向大范围补全。
Small-to-Big Retrieval 还有另外一种叫法:Parent Document Retrieval
1-2. 思考题
思考🤔:Small-to-Big Retrieval 和哪种 indexing 方式很搭配?
Small-to-Big Retrieval 通常会配合 Hierarchical Indexing 使用,因为它依赖“小块到大块”的层级关系。
另外关于“小块”、“大块”,实际上同一份内容,可能同时保留两层:
- 段落级 chunk:更完整,适合保留上下文
- 句子级 chunk:更细,适合精准命中
比如原文段落是:
病假超过 3 天,需提供医院诊断证明。若遇紧急情况无法提前申请,应在事后 24 小时内补提申请。可以切成两层:
段落级 chunk
chunk_p_1: 病假超过 3 天,需提供医院诊断证明。若遇紧急情况无法提前申请,应在事后 24 小时内补提申请。句子级 chunk
chunk_s_1: 病假超过 3 天,需提供医院诊断证明。
chunk_s_2: 若遇紧急情况无法提前申请,应在事后 24 小时内补提申请。
多个chunk之间建立关系:
- chunk_s_1 -> parent = chunk_p_1
- chunk_s_2 -> parent = chunk_p_1
这样检索时就可以:
- 先用句子级 chunk 精准命中
- 再回到它所属的段落级 chunk
- 把更完整的内容返回给模型
1-3. 示例代码
下面是一段适合辅助理解的 TypeScript 示例代码。模拟了:
- 先检索句子级小块
- 再根据 parentId 找回段落级大块
- 最后返回更完整的上下文
ts
type ParentChunk = {
  id: string;
  text: string;
};

type ChildChunk = {
  id: string;
  text: string;
  parentId: string;
};

const parentChunks: ParentChunk[] = [
  {
    id: "p1",
    text: "病假管理:病假超过 3 天,需提供医院诊断证明。若遇紧急情况无法提前申请,应在事后 24 小时内补提申请。",
  },
  {
    id: "p2",
    text: "年假管理:员工申请年假时,应至少提前 3 个工作日提交审批。",
  },
];

const childChunks: ChildChunk[] = [
  {
    id: "s1",
    text: "病假超过 3 天,需提供医院诊断证明。",
    parentId: "p1",
  },
  {
    id: "s2",
    text: "若遇紧急情况无法提前申请,应在事后 24 小时内补提申请。",
    parentId: "p1",
  },
  {
    id: "s3",
    text: "员工申请年假时,应至少提前 3 个工作日提交审批。",
    parentId: "p2",
  },
];

const query = "病假需要提供什么材料";

/**
 * 一个非常简化的“小块检索”
 * 这里只是为了演示流程,所以用关键词匹配代替真实向量检索。
 * 在真实项目里,这一步通常会是:
 * - 向量检索
 * - 或 BM25 / 全文检索
 */
function searchSmallChunks(query: string, chunks: ChildChunk[]) {
  const keywords = ["病假", "材料", "证明", "医院", "提供"];

  return chunks
    .map((chunk) => {
      let score = 0;

      for (const keyword of keywords) {
        // query 和 chunk 同时包含某个关键词,就加分
        if (query.includes(keyword) && chunk.text.includes(keyword)) {
          score += 1;
        }
      }

      return {
        ...chunk,
        score,
      };
    })
    .filter((item) => item.score > 0)
    .sort((a, b) => b.score - a.score);
}

/**
 * 根据命中的小块,回溯到它所属的大块
 * 这就是 Small-to-Big Retrieval 的关键步骤
 */
function expandToParentChunks(
  matchedChildren: Array<ChildChunk & { score: number }>,
  parents: ParentChunk[]
) {
  const parentMap = new Map(parents.map((p) => [p.id, p]));
  const seen = new Set<string>();

  const results: Array<ParentChunk & { sourceChildId: string }> = [];

  for (const child of matchedChildren) {
    if (seen.has(child.parentId)) {
      continue;
    }

    const parent = parentMap.get(child.parentId);
    if (!parent) {
      continue;
    }

    seen.add(child.parentId);

    results.push({
      ...parent,
      sourceChildId: child.id,
    });
  }

  return results;
}

// 1. 先检索小块
const matchedSmallChunks = searchSmallChunks(query, childChunks);

console.log("=== 先命中的小块 ===");
console.table(
  matchedSmallChunks.map((item) => ({
    id: item.id,
    text: item.text,
    parentId: item.parentId,
    score: item.score,
  }))
);

// 2. 再根据 parentId 找回更大的段落块
const expandedParents = expandToParentChunks(matchedSmallChunks, parentChunks);

console.log("=== 再补回所属的大块 ===");
console.table(
  expandedParents.map((item) => ({
    id: item.id,
    sourceChildId: item.sourceChildId,
    text: item.text,
  }))
);
2. Hypothetical Retrieval
这个名字大家应该很眼熟,因为之前在介绍检索前操作的时候,有介绍过 Hypothetical Document Embeddings,也就是 HyDE.
2-1. 基本概念
实际上,Hypothetical Retrieval 是一种宽泛的思路,凡是“先构造一个假设性的中间表示,再拿它去检索”的方法,都可以看作是这种思路。而这个中间表示可以是:
- 一个假设答案
- 一段假设文档
- 一组假设关键词
- 一组假设子问题
- 一个假设标题或标准问法
假设答案
这是最容易理解的一类。
做法是:
- 用户提问后
- 先让模型生成一个“可能的回答草稿”
- 再拿这个回答去检索
比如用户问:
笔记本蓝屏怎么办系统先假设一个答案:
笔记本蓝屏通常与驱动异常、系统文件损坏、硬件故障或散热问题有关,可从驱动、系统修复和硬件排查几个方向处理。然后再拿这段内容去搜。这和 HyDE 很接近,但你可以不强调“文档 embedding”这个形式,而强调“先生成假设答案”。
假设文档
这就是最典型的 HyDE 风格。
做法是:
- 不直接生成一个短答案
- 而是生成一段更像知识库文档的说明性文本
- 再拿这段“假想文档”去检索
比如把用户一句口语问题,先变成一段比较正式、比较像说明文的内容。
还是这个问题:
笔记本蓝屏怎么办?系统可能生成一段假设文档:
笔记本蓝屏故障排查说明:蓝屏问题通常与设备驱动、系统文件、硬件兼容性、内存异常、磁盘错误或散热问题有关。
用户可以先记录蓝屏错误代码,然后检查最近安装的软件或驱动,必要时执行系统文件检查和硬件诊断。
然后拿这段“像文档正文一样”的内容去检索。
它的重点是:我先构造一段“如果知识库里有相关内容,它大概会长这样”的文本,再用它去匹配真实知识库。
假设关键词集合
这类做法没有生成完整答案,而是先生成一组“如果答案相关,文档里大概率会出现的关键词”。
比如用户问:
苹果15续航咋样系统先假设相关词可能包括:
- iPhone 15
- 电池
- 续航
- 屏幕开启时间
- 低电量模式
- 视频播放
- 待机表现
然后拿这些词去做关键词检索或混合检索。
这种也能看成一种“先假设,再检索”,只是它假设的不是整段文档,而是“相关术语长什么样”。
假设子问题
有些复杂问题,系统会先假设:如果我要回答这个问题,我需要先搞清楚哪些子问题?
然后把这些子问题拿去检索。
比如用户问:
为什么我的笔记本一开会就特别卡系统可能先拆出假设性子问题:
- 是否是 CPU 占用过高
- 是否是内存不足
- 是否是视频会议软件兼容问题
- 是否是散热降频
然后分别检索这些方向。
这其实已经和 Query Decomposition 有点接近了,但如果这些子问题不是直接由原问题显式拆出来,而是模型“假设回答所需信息结构”后生成的,也可以看成广义的 hypothetical 思路。
假设FAQ标题 / 假设标准问法
有些知识库是 FAQ、工单、帮助中心类型,文档标题风格很固定。 这时系统可能会先生成一个“如果知识库里有这条内容,它的标题大概会怎么写”。
比如用户问:
苹果15续航咋样
系统先生成一个假设标题:
iPhone 15 电池续航表现说明
然后拿这个标题风格的文本去检索。
这种方法的本质也是:先把用户口语问题,映射成更像知识库表达方式的假设形式。
2-2. 注意点
另外注意 Hypothetical Retrieval 和 Query Rewrite 的区别。
Query Rewrite 是“把问题改得更像问题”
比如用户原话:
苹果15续航咋样改写后:
iPhone 15 的电池续航表现如何?这里本质上还是一个 query,只是更规范、更完整、更适合搜。
所以它做的是:
- 润色原问题
- 标准化表达
- 不改变“这是一个问题”这件事
Hypothetical Retrieval 是“先造一个像答案/像文档的东西”
同样这个问题:
苹果15续航咋样如果是 hypothetical retrieval,更像会先生成:
iPhone 15 的电池续航在日常使用、视频播放和待机场景下表现稳定,续航时长与电池容量、屏幕亮度和后台活动等因素有关。Query的内容已经不是问题了,而是:
- 像一段说明
- 像一段知识库正文
- 像“理想相关文档”的样子
然后系统再拿这段文本去检索。
所以它的重点不是“把问题改好”,而是先构造一个更像目标文档的中间文本。
3. 具体落地
接下来我们也需要讨论一下如何落地,整体上来讲还是这样的基本策略:
- SDK 提供框架,搭好了插槽和流水线,开发者提供策略。
- langchain中部分检索器实现封装到adapter包,开发者可以开箱即用
3-1. 开发者自己提供检索策略
也就是说,SDK 负责跑 preprocessor -> retriever -> postprocessor -> generator,具体怎么检索,由开发者自己在 preprocessor 或 retriever 里实现。举一个例子,开发者自己提供一个 Vector Search retriever:
ts
import {
  createDefaultRuntime,
  createIndexingRetrievalCandidate,
  filterRetrievalCandidatesByIndexingFilters,
} from "@rag-sdk/runtime";

const vectorSearcher = {
  async search(query: string, topK = 5) {
    // 这里假设你已经接好了自己的向量库
    return [
      {
        id: "chunk-1",
        content: "iPhone 15 的电池续航表现较上一代有所提升。",
        score: 0.92,
        metadata: {
          sourceId: "docs/apple",
          documentTitle: "iPhone 15 续航说明",
        },
      },
    ].slice(0, topK);
  },
};

const runtime = createDefaultRuntime({
  retriever: {
    async retrieve(request) {
      const docs = await vectorSearcher.search(request.effectiveQuery.query, request.topK ?? 5);

      // 把一个“chunk + metadata”包装成 runtime 可消费的 RetrievalCandidate
      const candidates = docs.map((doc) =>
        createIndexingRetrievalCandidate(
          {
            id: doc.id,
            content: doc.content,
            metadata: doc.metadata,
          },
          {
            score: doc.score,
            route: request.route,
            strategy: "vector-search",
            filters: request.filters,
          },
        ),
      );

      return {
        candidates: filterRetrievalCandidatesByIndexingFilters(
          candidates,
          request.filters,
        ),
        retrievalMetadata: {
          strategy: "vector-search",
        },
      };
    },
  },
  generator: ....
});
这个例子里,开发者自己提供的是:
vectorSearcher.search()- runtime 只是负责调用它,并把结果包装成 RetrievalCandidate
3-2. 提供一定封装,开发者开箱即用
当然,我们同样可以选择提供一定的封装,供开发者开箱即用。
例如在 langchain 中,大多数 VectorStore 实现都提供了 asRetriever() 方法,用于将向量库封装为统一的 Retriever 接口,从而可以被上层检索链直接使用。
一个简单的示例:
ts
import { OpenAIEmbeddings } from "@langchain/openai"
import { MemoryVectorStore } from "langchain/vectorstores/memory"

// 1. 构建向量库
const vectorStore = await MemoryVectorStore.fromTexts(
  ["LangChain 很强大", "RAG 是一种检索增强生成技术"],
  [{}],
  new OpenAIEmbeddings()
)

// 2. 转换为 Retriever
const retriever = vectorStore.asRetriever()

// 3. 直接用于检索
const result = await retriever.invoke("什么是 RAG?")

console.log(result)
那么我们可以在 adapter 中提供一层封装,目录如下:
adapters
└── src
    ├── shared
    ├── langchain
    │   ├── loaders
    │   ├── chunkers
    │   ├── embedders
    │   ├── retrievers
    │   │   ├── runtime-retriever-adapter
    │   │   ├── base-retriever-runtime-adapter
    │   │   └── vector-store-runtime-retriever-adapter
    │   └── shared
    └── chroma
为什么要分三层,而不是只写一个文件?
因为这样职责更清楚,也更方便复用。
如果不分层,所有逻辑都堆在一个文件里,会有几个问题:
- 通用映射逻辑和具体 LangChain 类型耦合在一起
- 以后要支持别的 retriever 类型时,容易重复造轮子
- VectorStore 这种“更高层的便捷封装”没法复用已有逻辑
分层之后就很自然:
- 第一层解决“怎么把 LangChain 结果转成 RuntimeCandidate”
- 第二层解决“怎么接标准 BaseRetriever”
- 第三层解决“怎么让 VectorStore 用户直接开箱即用”
这就是典型的:底层保留通用能力,上层不断做便利性封装。
3-2-1. runtime-retriever-adapter
前面我们已经说过,runtime 包希望接收的是一个统一的 RuntimeRetriever:
ts
export interface RuntimeRetriever {
  retrieve(
    request: RetrievalRequest,
    context: RuntimeContext,
  ): Promise<RuntimeRetrievalResult>;
}
也就是说,不管底层用的是向量检索、关键词检索、混合检索,还是 LangChain 里的某个 retriever,最终都要返回我们 SDK 能理解的结构:
ts
{
  candidates: RetrievalCandidate[]
}
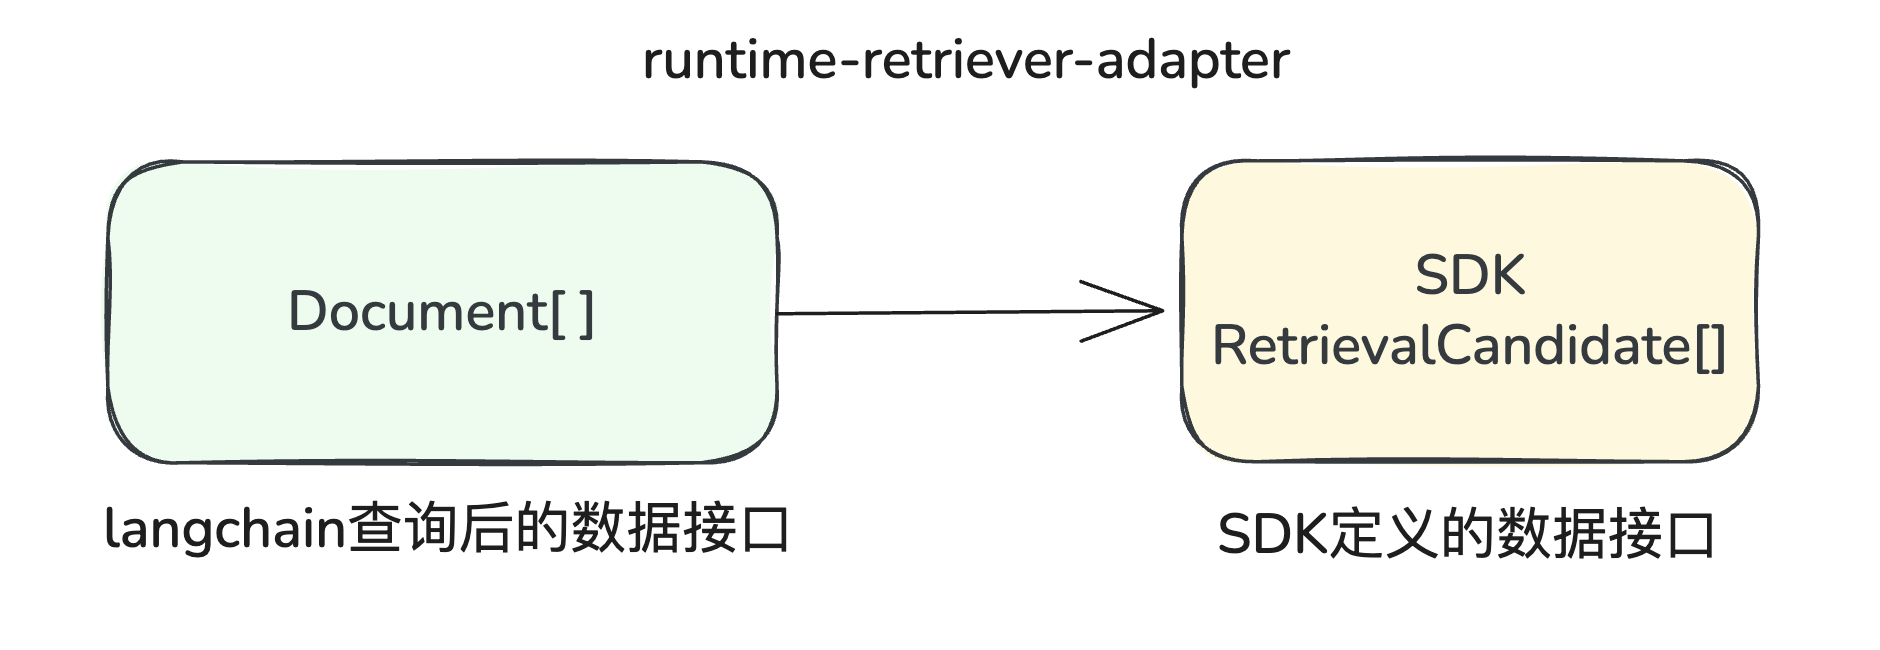
问题在于,LangChain 里的 retriever 返回的通常是 Document[]:
ts
[
  {
    pageContent: "RAG 是一种检索增强生成技术。",
    metadata: {
      sourceId: "docs/rag",
      score: 0.92,
    },
  },
];
而我们 runtime 更希望拿到的是统一的候选结果:
ts
[
  {
    id: "chunk-1",
    content: "RAG 是一种检索增强生成技术。",
    score: 0.92,
    metadata: {
      sourceId: "docs/rag",
      score: 0.92,
    },
    strategy: "langchain-retriever",
  },
];
这中间就存在一个很典型的适配问题:
ts
LangChain Document[] → SDK RetrievalCandidate[]所以我们需要第一层 adapter:runtime-retriever-adapter。
它是最底层、最通用的一层。它不关心你底层到底是:
BaseRetrieverVectorStore.asRetriever()- 自定义 LangChain retriever
- 还是别的能返回
Document[]的检索器
它只负责一件事:把 LangChain 风格的检索结果,转换成 SDK runtime 能统一消费的 RetrievalCandidate。
如下图所示:
如果没有这一层,每接入一个 LangChain retriever,开发者都要重复写类似代码:
ts
const docs = await retriever.invoke(query);

const candidates = docs.map((doc, index) => ({
  id: doc.id ?? `chunk-${index}`,
  content: doc.pageContent,
  metadata: doc.metadata,
  score: doc.metadata?.score,
}));
这段代码本身不复杂,但它会在很多地方反复出现。
比如:
- 接
VectorStore.asRetriever()要写一遍 - 接
BM25Retriever要写一遍 - 接
HyDE Retriever要写一遍 - 接自定义 LangChain Retriever 还要再写一遍
这就会带来几个问题:
- 转换规则分散在各处,后面不好统一维护
- 字段命名容易不一致,比如有的地方叫
content,有的地方叫pageContent - score 提取逻辑容易重复,比如有的 retriever 放在
metadata.score,有的放在metadata.relevanceScore - runtime 层无法稳定假设 retriever 返回什么结构
所以第一层 adapter 的意义是:把“LangChain Document 到 SDK Candidate”的转换逻辑集中起来。
示意代码
这一层可以写成一个通用 adapter:
ts
// langchain-runtime-retriever-adapter.ts

type LangChainDocument = {
  id?: string;
  pageContent: string;
  metadata?: Record<string, any>;
};

class LangChainRuntimeRetrieverAdapter {
  constructor(
    private options: {
      retriever: {
        invoke(input: any): Promise<any>;
      };

      mapRequest?: (request: RuntimeRequest) => any;

      extractDocuments?: (result: any) => LangChainDocument[];

      extractScore?: (doc: LangChainDocument) => number | undefined;
    },
  ) {}

  async retrieve(request: RuntimeRequest) {
    // 1. 把 runtime request 转成 LangChain retriever 的输入
    const input = this.options.mapRequest
      ? this.options.mapRequest(request)
      : request.effectiveQuery.query;

    // 2. 调用 LangChain retriever
    const result = await this.options.retriever.invoke(input);

    // 3. 从返回结果里抽出 Document[]
    const docs = this.options.extractDocuments
      ? this.options.extractDocuments(result)
      : result;

    // 4. 把 Document[] 转成 SDK 内部统一的 candidates
    const candidates = docs.map((doc, index) => ({
      id: doc.id ?? `chunk-${index}`,
      content: doc.pageContent,
      metadata: doc.metadata,
      score: this.options.extractScore
        ? this.options.extractScore(doc)
        : doc.metadata?.score,
      strategy: request.strategy ?? "langchain-retriever",
    }));

    return {
      candidates,
    };
  }
}
这段代码可以不用追求完整工程实现,重点是表达清楚这层 adapter 的职责:
RuntimeRequest → LangChain Retriever → LangChain Document[] → SDK RetrievalCandidate[]举个实际例子
假设我们有一个 LangChain retriever:
ts
const retriever = {
  async invoke(query: string) {
    return [
      {
        pageContent: "RAG 可以通过检索外部知识增强大模型回答。",
        metadata: {
          sourceId: "docs/rag-intro",
          score: 0.91,
        },
      },
    ];
  },
};
接入 LangChainRuntimeRetrieverAdapter 之后:
ts
const runtimeRetriever = new LangChainRuntimeRetrieverAdapter({
  retriever,
});
runtime 调用时:
ts
const result = await runtimeRetriever.retrieve({
  effectiveQuery: {
    query: "什么是 RAG?",
  },
  strategy: "vector-search",
});
最终拿到的是 SDK 内部统一格式:
ts
{
  candidates: [
    {
      id: "chunk-0",
      content: "RAG 可以通过检索外部知识增强大模型回答。",
      metadata: {
        sourceId: "docs/rag-intro",
        score: 0.91,
      },
      score: 0.91,
      strategy: "vector-search",
    },
  ];
}
这样,后面的 rerank、filter、generator 都不用关心底层是不是 LangChain,只要消费统一的 RetrievalCandidate 即可。
所以,runtime-retriever-adapter 是第一层,也是最通用的一层。
它解决的是:如何把 LangChain 风格的检索结果,统一转换成 SDK runtime 可以消费的候选结果。
3-2-2. base-retriever-runtime-adapter
有了第一层 runtime-retriever-adapter 之后,我们已经能处理这件事:
ts
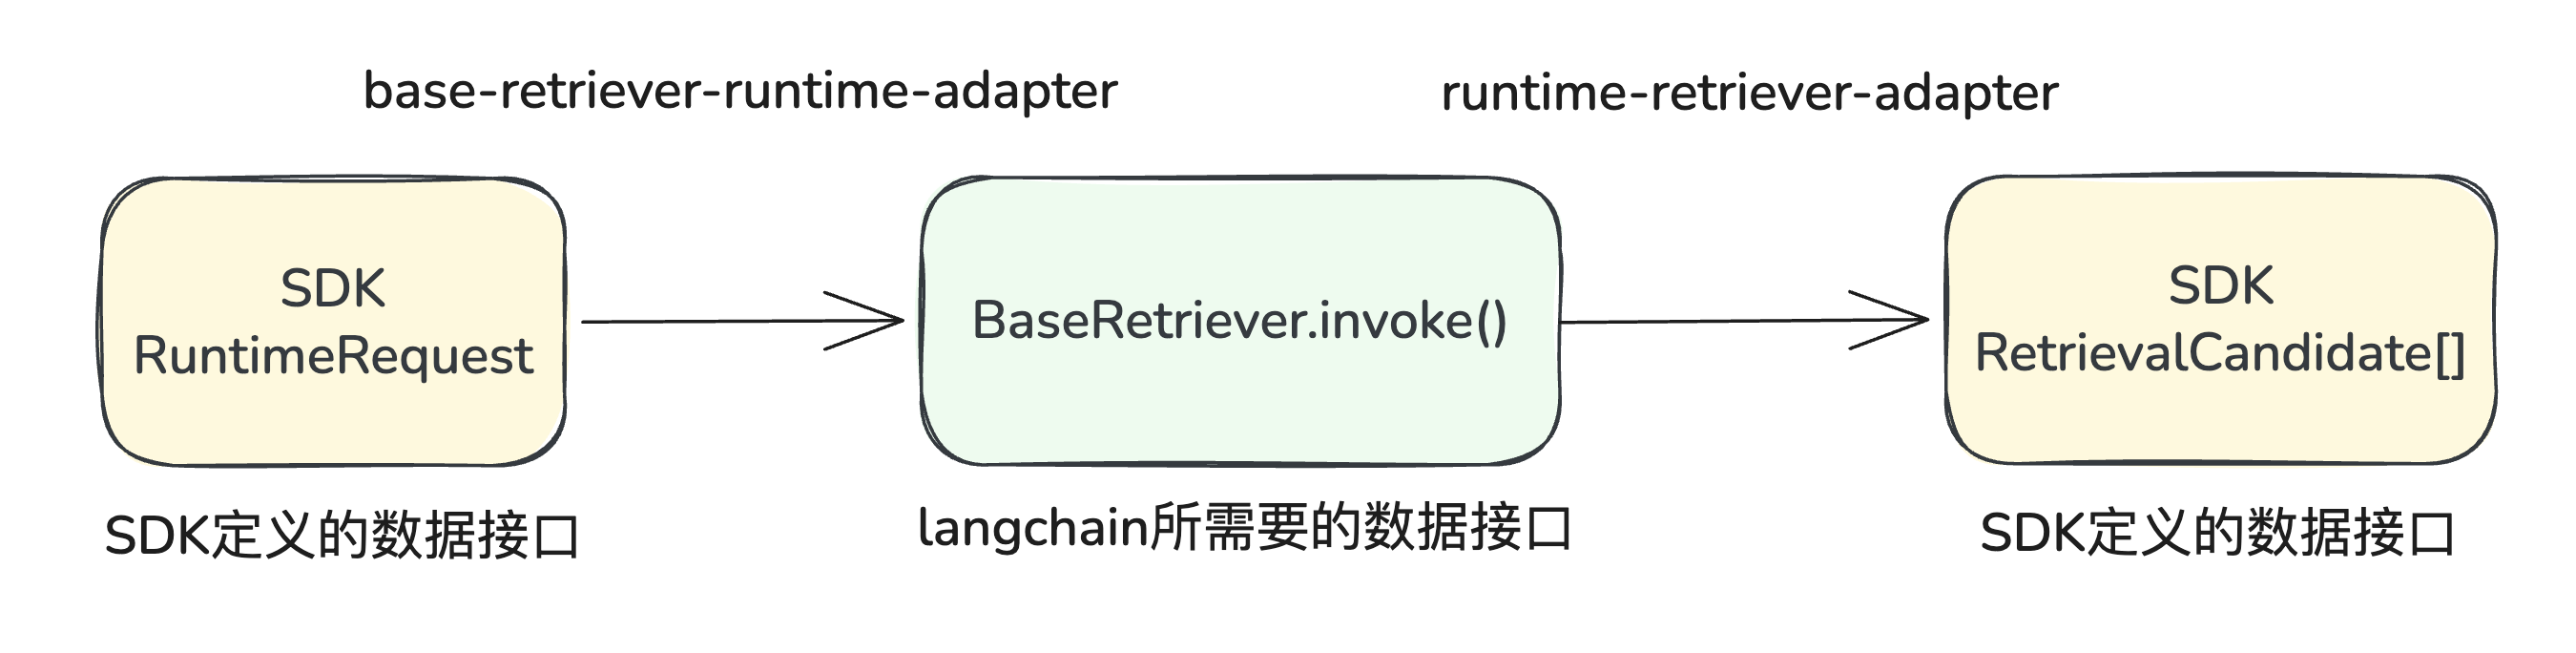
LangChain Document[] → SDK RetrievalCandidate[]但是还没有解决另一个问题:LangChain 的 BaseRetriever 和我们 SDK 的 RuntimeRequest 输入格式并不一样。
先看我们 SDK 的检索请求。
在 runtime 里,一个检索请求通常不只是一个字符串,而是一个完整的 RetrievalRequest:
ts
export type RetrievalRequest = {
  originalQuery: Query;
  effectiveQuery: Query;
  topK?: number;
  filters?: RetrievalFilters;
  strategy?: string;
  route?: string;
  rewriteReason?: string;
  indexingMode?: "full" | "incremental";
  budget?: RetrievalBudget;
  rerank?: RetrievalRerankPolicy;
  metadata?: Record<string, JsonValue>;
};
比如一次实际请求可能长这样:
ts
const request = {
  originalQuery: {
    query: "RAG 是什么?",
  },
  effectiveQuery: {
    query: "什么是 Retrieval-Augmented Generation?",
  },
  topK: 5,
  filters: {
    sourceId: "docs/rag",
  },
  strategy: "vector-search",
};
但是 LangChain 的 BaseRetriever 通常只关心一个更简单的输入:
ts
await baseRetriever.invoke("什么是 Retrieval-Augmented Generation?");也就是说,两边的输入模型不一样:
- SDK RuntimeRequest:完整检索请求,包含 query、filters、topK、strategy 等信息
- LangChain BaseRetriever:通常只需要 query,最多再带一些 RunnableConfig
这就是第二层 adapter 要解决的问题。
为什么还要再封装一层?
你可能会问:既然 runtime-retriever-adapter 已经能调用 retriever 了,为什么还要再写一个 base-retriever-runtime-adapter?
原因是:BaseRetriever 是 LangChain 里非常常见的一种标准抽象,值得单独做一层便捷封装。
如果不封装,开发者每次接入 BaseRetriever,都要自己告诉通用 adapter:
- 从
request里取哪个 query - 怎么调用
baseRetriever.invoke() - 是否要传入 config
- LangChain 返回的结果是不是
Document[] - score 从 metadata 的哪个字段取
这些都是很稳定、很重复的规则。
所以第二层 adapter 的意义是:把接入 LangChain BaseRetriever 时的常见规则提前写好,让开发者不用每次都写 mapRequest、invoke、extractDocuments 这些样板代码。
如果没有这一层,开发者要怎么写?
假设开发者已经有一个 LangChain retriever:
ts
const baseRetriever = vectorStore.asRetriever({
  k: 5,
});
如果没有 base-retriever-runtime-adapter,他可能要这样接入:
ts
const runtimeRetriever = new LangChainRuntimeRetrieverAdapter({
  retriever: {
    invoke(input: { query: string }) {
      return baseRetriever.invoke(input.query);
    },
  },

  mapRequest(request: RuntimeRequest) {
    return {
      query: request.effectiveQuery.query,
    };
  },

  extractDocuments(result: LangChainDocument[]) {
    return result;
  },

  extractScore(doc: LangChainDocument) {
    return doc.metadata?.score;
  },
});
这段代码没有什么业务含义,本质上就是在反复做接口对齐:
- RuntimeRequest.query 取出来
- 传给
BaseRetriever.invoke() - 拿到
Document[] - 交给通用 adapter 转 candidates
如果每个开发者都要写这一段,使用体验就会比较差。
base-retriever-runtime-adapter 做了什么?
base-retriever-runtime-adapter 就是把上面这些固定逻辑封装掉。
示意代码如下:
ts
// langchain-base-retriever-runtime-adapter.ts

function createLangChainBaseRetrieverRuntimeAdapter(baseRetriever: any) {
  return new LangChainRuntimeRetrieverAdapter({
    // 1. BaseRetriever 的调用方式是 invoke(query)
    retriever: {
      invoke: (input: { query: string; config?: any }) => {
        return baseRetriever.invoke(input.query, input.config);
      },
    },

    // 2. RuntimeRequest 里真正用于检索的是 effectiveQuery.query
    mapRequest: (request: RuntimeRequest) => {
      return {
        query: request.effectiveQuery.query,
      };
    },

    // 3. BaseRetriever 返回的通常就是 Document[]
    extractDocuments: (result: LangChainDocument[]) => {
      return result;
    },

    // 4. 默认从 metadata.score 中读取分数
    extractScore: (doc: LangChainDocument) => {
      return doc.metadata?.score;
    },
  });
}
这样开发者使用时就很简单:
ts
const runtimeRetriever = createLangChainBaseRetrieverRuntimeAdapter(baseRetriever);他不需要再关心:
request.effectiveQuery.query应该怎么取baseRetriever.invoke()应该怎么调用Document[]应该怎么抽出来pageContent应该怎么映射成contentmetadata.score应该怎么映射成score
这些都由 adapter 统一处理。
举个带 config 的例子
有些时候,我们还希望把 runtime 的上下文信息传给 LangChain,比如:
- requestId
- tags
- callbacks
- tracing metadata
LangChain 的 Runnable 通常支持传入 config。
如果没有 adapter,开发者可能会手写:
ts
const docs = await baseRetriever.invoke(query, {
  tags: ["rag", "runtime"],
  metadata: {
    requestId: context.requestId,
  },
});
但这个逻辑每个 retriever 都写一遍,也会很重复。
所以 base-retriever-runtime-adapter 可以允许开发者提供一个 mapRunnableConfig:
ts
const runtimeRetriever =
  createLangChainBaseRetrieverRuntimeAdapter(baseRetriever, {
    mapRunnableConfig: (request, context) => ({
      tags: ["rag", request.strategy],
      metadata: {
        requestId: context.requestId,
        route: request.route,
      },
    }),
  });
内部可以这样处理:
ts
function createLangChainBaseRetrieverRuntimeAdapter(
  baseRetriever: any,
  options: {
    mapRunnableConfig?: (
      request: RuntimeRequest,
      context: RuntimeContext,
    ) => any;
  } = {},
) {
  return new LangChainRuntimeRetrieverAdapter({
    retriever: {
      invoke: (input: { query: string; config?: any }) => {
        return baseRetriever.invoke(input.query, input.config);
      },
    },

    mapRequest: (request, context) => {
      return {
        query: request.effectiveQuery.query,
        config: options.mapRunnableConfig?.(request, context),
      };
    },

    extractDocuments: (result) => result,
  });
}
这样做之后,开发者既可以使用默认行为,也可以在需要时把 runtime 上下文映射成 LangChain config。
举个 score 字段不一致的例子
不同 retriever 返回的分数字段可能并不统一。
有的可能是:
ts
metadata: {
  score: 0.91;
}
有的可能是:
ts
metadata: {
  relevanceScore: 0.91;
}
有的可能是:
ts
metadata: {
  _score: 0.91;
}
如果没有统一封装,开发者可能到处写:
ts
const score =
  doc.metadata?.score ??
  doc.metadata?.relevanceScore ??
  doc.metadata?._score;
这类逻辑也可以放到 adapter 里统一处理:
ts
const runtimeRetriever =
  createLangChainBaseRetrieverRuntimeAdapter(baseRetriever, {
    extractScore: (doc) => {
      return (
        doc.metadata?.score ??
        doc.metadata?.relevanceScore ??
        doc.metadata?._score
      );
    },
  });
这样无论底层 retriever 的 metadata 长什么样,最终进入 runtime 的都是统一的 score 字段。
这一层和上一层的关系
到这里,两层 adapter 的边界就比较清楚了。
- 第一层
runtime-retriever-adapter解决的是:LangChain Document[]怎么变成SDK RetrievalCandidate[] - 第二层
base-retriever-runtime-adapter解决的是:SDK RuntimeRequest怎么接到 langchain 的BaseRetriever.invoke()
它们的关系可以理解成:
createLangChainBaseRetrieverRuntimeAdapter()
        ↓
内部复用 LangChainRuntimeRetrieverAdapter
        ↓
LangChainRuntimeRetrieverAdapter 负责最终结果转换
换句话说:
runtime-retriever-adapter是通用转换内核base-retriever-runtime-adapter是面向 BaseRetriever 的便捷入口
如下图所示:
总结一下,base-retriever-runtime-adapter 这一层不是简单“套一层壳”。
它解决的是:当开发者手里已经有一个 LangChain BaseRetriever 时,如何用最少的代码把它接入我们 SDK 的 runtime。
它帮开发者省掉的是这些重复逻辑:
RuntimeRequest → query
RuntimeContext → RunnableConfig
BaseRetriever.invoke(query, config)
Document[] → candidates
metadata.score → score
因此这一层的定位可以总结为:专门适配 LangChain BaseRetriever 的便捷封装层。
如果开发者手上已经是一个 BaseRetriever,那就不需要直接面对底层通用 adapter,直接调用:
ts
const retriever = createLangChainBaseRetrieverRuntimeAdapter(baseRetriever);就可以接入 SDK runtime。
3-2-3. vector-store-runtime-retriever-adapter
这是第三层,也是最面向“开箱即用”的一层。
它的作用是:专门适配 LangChain VectorStore,内部自动帮你调用 asRetriever(),再接到 base-retriever-runtime-adapter。
也就是说,开发者甚至不需要自己先写:
const retriever = vectorStore.asRetriever(...)而是只需要把 vectorStore 传进来,adapter 内部帮他完成:
vectorStore.asRetriever()- 把这个 retriever 交给 base-retriever-runtime-adapter
- 最终变成 SDK 可直接用的 RuntimeRetriever
所以这一层最像:“如果开发者手上连 retriever 都没有,只有一个 VectorStore,那直接用我。”
示例代码:
ts
// langchain-vector-store-runtime-retriever-adapter.ts

import { createLangChainBaseRetrieverRuntimeAdapter } from "./langchain-base-retriever-runtime-adapter.js";

export function createLangChainVectorStoreRuntimeRetrieverAdapter(options) {
  const baseRetriever = options.vectorStore.asRetriever({
    k: options.k ?? 4,
    searchType: options.searchType ?? "similarity",
  });

  return createLangChainBaseRetrieverRuntimeAdapter({
    retriever: baseRetriever,
    mapQuery: options.mapQuery,
    mapRunnableConfig: options.mapRunnableConfig,
    extractScore: options.extractScore,
    filterByRequest: options.filterByRequest,
  });
}
开发者开箱即用
开发者侧最理想的体验就是:
- 准备好 langchain VectorStore
- 调一个 SDK 提供的 adapter 工厂
- 直接丢给
createDefaultRuntime()
ts
import { createDefaultRuntime } from "@rag-sdk/runtime";
import { createLangChainVectorStoreRuntimeRetrieverAdapter } from "@rag-sdk/adapters";

import { OpenAIEmbeddings } from "@langchain/openai";
import { MemoryVectorStore } from "@langchain/classic/vectorstores/memory";

const embeddings = new OpenAIEmbeddings({
  model: "text-embedding-3-small",
});

const vectorStore = new MemoryVectorStore(embeddings);

await vectorStore.addDocuments([
  {
    pageContent: "Runtime API explains the online query pipeline.",
    metadata: {
      sourceId: "docs/runtime",
      hierarchyPath: ["runtime", "api"],
    },
  },
  {
    pageContent: "Runtime FAQ explains common retrieval issues.",
    metadata: {
      sourceId: "docs/faq",
      hierarchyPath: ["runtime", "faq"],
    },
  },
]);

const retriever = createLangChainVectorStoreRuntimeRetrieverAdapter({
  vectorStore,
  k: 4,
  searchType: "similarity",
});

const runtime = createDefaultRuntime({
  retriever,
  generator: {
    async generate({ request, chunks }) {
      return {
        answer: [
          `query: ${request.effectiveQuery.query}`,
          ...chunks.map((chunk) => chunk.content),
        ].join("\n\n"),
      };
    },
  },
});

const result = await runtime.run({
  query: "Explain runtime pipeline",
});

console.log(result);
除了把 VectorStore 直接转成 Retriever,官方/社区已经有现成实现的 retriever:
- BM25Retriever:适合做 Keyword Search
- HyDE Retriever:Hypothetical Retrieval
- Supabase Hybrid Search:适合做 Hybrid Search
还有一批外部检索器,比如 ArxivRetriever、TavilySearchAPIRetriever 等。
4. 相关面试题
题目1
题目
在 RAG 系统中,Retriever 的作用是什么?如果让你接入一个自定义向量检索器,你会如何设计?
题目分析
理想回答通常会涉及:
- Retriever 位于在线查询链路中间,一般负责从知识库 / 索引 / 向量库中取回候选内容
- Retriever 的输入通常是用户 query、改写后的 query、过滤条件、topK 等
- Retriever 的输出不应该只是字符串,而应该包含:
- chunk 内容
- score
- metadata
- source 信息
- strategy 信息
- 在工程设计上,不建议把向量库调用逻辑和 runtime 强耦合
- 更合理的做法是:
- runtime 定义统一的 Retriever 接口
- 开发者实现具体检索逻辑
- runtime 只负责调用它,并把结果包装成统一的 RetrievalCandidate
- 如果候选人能讲清楚“检索实现”和“运行时编排”的边界,会比较加分
这题适合考察候选人是否真的理解 RAG 的工程链路,而不是只知道“RAG = 向量检索 + 大模型”。
参考答案
在 RAG 系统里,Retriever 的核心作用是根据当前 query,从知识库或索引系统里取回一批候选上下文。它决定了后面的 LLM 能看到什么材料,所以 Retriever 的质量会直接影响最终回答质量。
如果让我接入一个自定义向量检索器,我不会把向量库逻辑直接写死在 runtime 里面。更合理的方式是让 runtime 只定义统一的检索接口,比如
retrieve(request),然后由开发者自己实现底层的vectorSearcher.search()。检索器拿到 query 和 topK 后,去向量库里搜索相关 chunk,返回内容、分数和 metadata。runtime 再把这些结果包装成统一的 RetrievalCandidate,比如包含 id、content、score、sourceId、documentTitle、filters、strategy 等字段。
这样做的好处是,runtime 负责流程编排,retriever 负责具体检索实现,两者边界清楚。以后底层从 Chroma 换成 Pinecone,或者从纯向量检索换成混合检索,runtime 不需要大改,只需要替换 retriever 实现即可。
题目2
题目
Small-to-Big Retrieval 是什么?它和 Hierarchical Indexing 有什么关系?
题目分析
理想回答通常会涉及:
- Small-to-Big Retrieval 的核心是:先命中小粒度 chunk,再补回更大的上下文
- 它不是“重新切块算法”,而是一种 检索策略
- 小块用于提高命中精度,大块用于补足上下文完整性
- 常见实现方式包括:
- 小块命中后回到父 section
- 回溯相邻 chunk
- 根据 parent_id / section_id / hierarchyPath 补全上下文
- 它通常和 Hierarchical Indexing 很搭,但不一定必须有完整层级索引
- 更本质的前提是:系统里要有“小块到大块”的关联关系
- 如果候选人能讲清“索引阶段切块”和“检索阶段回补”的区别,会很加分
这题很适合考察候选人是否真的理解 索引设计和检索设计的边界。
参考答案:
Small-to-Big Retrieval 我会把它理解成一种“先小后大”的检索策略。也就是先用更细粒度的 chunk 去做召回,因为这样更容易精准命中;命中之后,再把它所在的更大上下文,比如整个 section、父段落或者相邻 chunk,一起补回来交给模型。
这么做的原因很简单。块太大,检索容易不准;块太小,上下文又容易不完整。所以它其实是在平衡“召回精度”和“上下文完整性”。
它和 Hierarchical Indexing 的关系是,这两者很搭,但不完全等价。
- Hierarchical Indexing 更偏索引设计,解决的是 chunk 和 section、document 之间有没有层级关系;
- Small-to-Big Retrieval 更偏检索策略,解决的是检索时怎么利用这些关系。
也就是说,层级索引是很典型的实现基础,但更本质的要求其实是系统里得有“小块到大块”的关联信息。
题目3
题目
Hypothetical Retrieval 是什么?它和 Query Rewrite 有什么区别?
题目分析
理想回答通常会涉及:
- Query Rewrite 的核心是“改写问题”,生成的仍然是 query
- Hypothetical Retrieval 的核心是“先生成假设答案 / 假想文档,再去检索”
- HyDE 通常可以看作 Hypothetical Retrieval 的典型实现
- 两者都发生在检索前,所以很容易混淆
- 区别重点在于:
- Rewrite:产物还是问题表达
- Hypothetical:产物更像答案表达或文档表达
- 这类策略适合:
- query 很短
- query 很口语化
- 用户表达和知识库文档风格差异很大
- 也要说明风险:中间假设如果偏了,检索方向也可能被带偏
这题很能拉开差距,因为它同时考察 概念区分能力 和 检索前增强策略理解。
参考答案
这两个很容易混,我自己的区分方式是这样的:Query Rewrite 还是在改写问题,只是把原来口语化、模糊的 query 变得更标准、更清晰,但产物本质上还是一个 query。比如“苹果15续航咋样”改成“iPhone 15 的电池续航表现如何”,这还是一个问题。
但 Hypothetical Retrieval 不一样,它不是继续改问题,而是先生成一个“假设答案”或者“假想文档”,再拿这个中间结果去检索。也就是说,它生成的东西已经更像知识库里的正文表达了。HyDE 就是这里面很典型的一种做法。
为什么要这么做?
因为很多用户问题太短、太口语,直接拿去搜不一定效果最好;如果先生成一段更像目标文档的文本,往往更容易命中相关内容。
当然它也有风险,就是如果这个“假设”本身偏了,后面的检索方向也可能跟着偏掉。所以我会把它看成一种更激进的检索前增强策略。
题目4
题目
VectorStoreRetriever 在 LangChain 中是如何工作的?
题目分析
理想回答通常会涉及:
- VectorStoreRetriever 是 LangChain 中常见的 Retriever 类型
- 它底层依赖 VectorStore 的相似度搜索能力
- 文档会先被 embedding 成向量,并存入 VectorStore
- 用户 query 也会被 embedding 成向量
- 系统通过余弦相似度、点积、欧氏距离等方式找到最相似的文档 chunk
- 返回结果通常是 Document 列表,包含 pageContent 和 metadata
- 在 RAG 中,这些检索结果会作为上下文交给 LLM
- 如果候选人能补充
asRetriever()的作用,会更好:它可以把 VectorStore 包装成统一 Retriever 接口,方便接入上层 RAG 链路
参考答案
VectorStoreRetriever 可以理解成 LangChain 里基于向量库实现的一种检索器。它的工作方式是:先把文档切分成 chunk,然后通过 embedding 模型把 chunk 转成向量,并存入 VectorStore。
当用户提出问题时,系统也会把 query 转成向量,然后到 VectorStore 里做相似度搜索,找到和 query 最接近的若干个文档片段。
这些返回结果通常不是普通字符串,而是 Document 对象,里面会包含 pageContent 和 metadata。后续 RAG 链路会把这些内容作为上下文拼进 prompt,再交给大模型生成答案。
在 LangChain 里,很多 VectorStore 可以通过
asRetriever()转成 Retriever。这样上层链路就不用关心底层是 Chroma、FAISS、Pinecone 还是 MemoryVectorStore,只需要按照统一的 Retriever 接口调用即可。
追问:LangChain 中的 VectorStore 为什么要通过 asRetriever() 转成 Retriever?如果你在 SDK 里封装这类能力,会怎么分层?
题目分析
理想回答通常会涉及:
- VectorStore 更偏底层存储与相似度搜索
- Retriever 更偏统一的“检索接口”
asRetriever()的作用是把向量库包装成标准检索器- 这样上层链路不需要关心底层是 Chroma、FAISS、Pinecone 还是 MemoryVectorStore
- 在 SDK 设计里,不建议只写一个大 adapter 文件
- 可以拆成三层:
- 通用 runtime-retriever-adapter:把外部检索结果转成 RuntimeCandidate / RetrievalCandidate
- base-retriever-runtime-adapter:专门适配 LangChain BaseRetriever
- vector-store-runtime-retriever-adapter:专门适配 LangChain VectorStore,内部自动调用
asRetriever()
- 这体现的是 adapter 设计思想:底层保留通用能力,上层提供开箱即用封装
参考答案
VectorStore 本质上更偏底层,它负责存储向量、做相似度搜索。而 Retriever 更偏上层接口,它提供统一的“根据 query 取回 documents”的能力。
所以
asRetriever()的价值在于,它把具体向量库封装成统一的 Retriever。这样上层 RAG 链路不用关心底层到底是 Chroma、FAISS、Pinecone,还是 MemoryVectorStore,只要按照 Retriever 接口调用即可。如果我在 SDK 里封装这类能力,我不会只写一个很大的 adapter。更合理的是分层:
第一层是最通用的 runtime retriever adapter,只负责把外部 retriever 返回的 documents 映射成 SDK 内部的 RetrievalCandidate。
第二层是 BaseRetriever adapter,专门适配 LangChain 标准的 BaseRetriever,处理 query、config、documents、score 这些样板逻辑。
第三层是 VectorStore adapter,面向用户提供更方便的开箱即用能力。用户只要传入 vectorStore,adapter 内部自动调用
vectorStore.asRetriever(),然后再接到 BaseRetriever adapter,最后变成 SDK runtime 可以直接使用的 retriever。这样设计的好处是,底层通用逻辑可以复用,上层使用体验也比较简单。以后支持新的 LangChain Retriever,或者支持别的框架,也不需要推翻整个 runtime 设计。
-EOF-