Appearance
RAG SDK准备工作
接下来我们来聊一下在正式开始之前,需要做什么准备工作。
根据我们前面的规划,整个 RAG SDK 是一个 monorepo 项目,包的拆分如下:
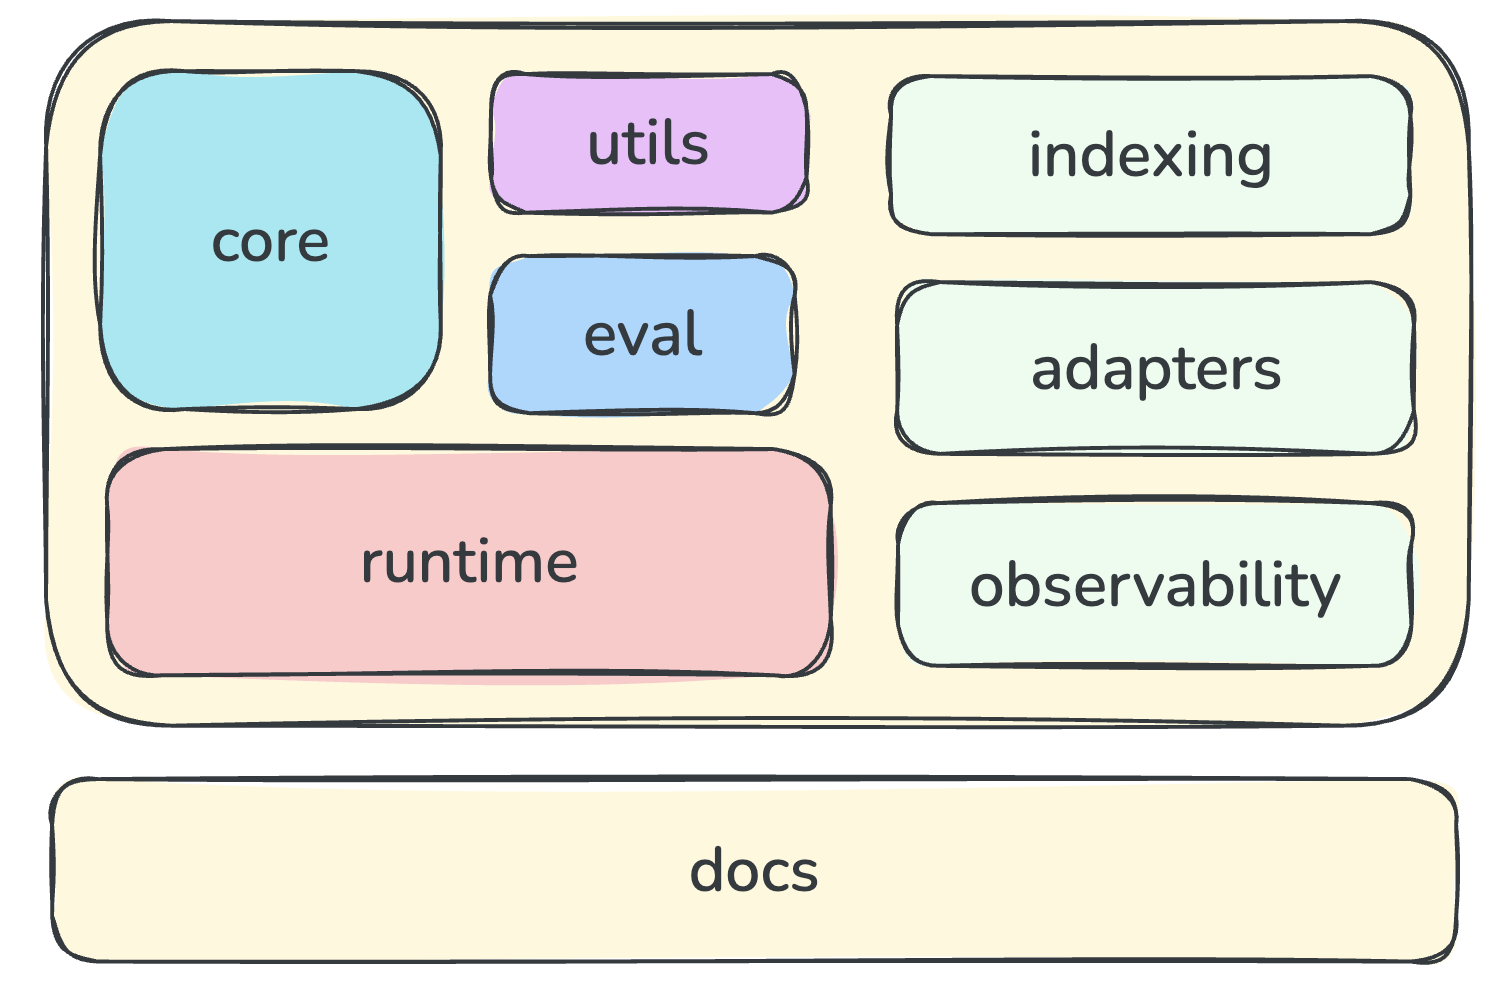
准备工作这一块儿,我们做 2 个事情:
- 确定安装包与测试策略
- 完成 core 包的设计
1. 安装包策略
因为是多包结构,那么这里就会涉及到安装包的一个策略问题,比如 typescript、eslint.... 这些包应该如何安装?哪些装在根目录,哪些装在各自的包下面?整体来讲,安装包的策略如下:
1. 哪些包应该安装在“根目录”?
通常是那些开发工具类、全局构建类的包。
- TypeScript (
typescript):必须在根目录,保证整个项目使用同一个编译版本,避免包与包之间因为 TS 版本不一致产生的类型冲突。 - 构建/代码质量工具:如
eslint,prettier,vitest,tsup(如果你用它打包)。 - Workspace 管理工具:如
pnpm相关的插件。
安装命令:
bash
pnpm add typescript -w -D
-w代表workspace-root,-D代表devDependencies。
2. 哪些包应该安装在“子包(packages/xx)”?
即使所有子包都用到了某个功能,如果它是运行时(Runtime)依赖,也建议安装在子包中。
- Zod:虽然
core、runtime都会用到,但建议分别在各子包内安装。 - 工具函数库(如
lodash-es):安装在子包中。
原因:
- 显式依赖:每个包的
package.json应该能独立描述运行它需要什么,这样发布到 NPM 后,用户安装你的core包时,才能自动下载zod。 - pnpm 特性:pnpm 会使用符号链接(Symbolic Links)处理重复依赖。即使你在 5 个子包里都装了
zod,在磁盘上也只有一份物理存储,不会浪费空间。
总结一下
在 Monorepo 中,依赖管理遵循“谁使用,谁声明”的原则。
- 开发工具(如 TypeScript、Vitest、ESLint)统一安装在根目录。
- 运行时依赖(如 zod、openai、lodash)必须安装在实际使用它的子包中,不能依赖其它包的隐式依赖。
- 每个子包的 package.json 必须能独立描述其运行依赖,以保证发布后的可用性。
pnpm 会自动去重依赖,因此无需担心重复安装带来的空间问题。
2. 测试策略
由于我们是 vibe coding,因此有一个东西非常重要,那就是测试策略,这可以大大增强我们对 AI 所生成的代码的信心。
在传统开发中,代码是由人编写的,整体流程为:人写代码 → 人理解代码 → 人保证正确性
但在 AI 参与的开发模式下,情况发生了变化:AI 生成代码 → 人无法完全逐行验证 → 必须依赖系统化验证
因此,我们需要一套从编译期 → 运行时 → 行为层 → 系统层逐层收敛的验证体系。
整个验证体系我们可以分为 5 个维度:
- Type 验证:基于 TypeScript 的静态类型检查。
- Spec 验证:基于 Zod 的运行时数据结构校验。
- Unit Test:基于 Vitest 的单元逻辑测试。
- Demo 验证:包级别的最小可运行示例。
- Integration:跨包协同工作的集成测试。
2-1. Type 验证
这属于编译期验证,属于第一道防线。
bash
pnpm -r exec tsc --noEmit作用:
- 保证类型正确
- 保证接口调用一致
- 提前发现结构不匹配问题
但需要注意:
- TypeScript 只能保证“写出来的代码是类型安全的”
- 无法保证“运行时的数据是正确的”
2-2.Spec 验证
这是运行时结构校验,这一层由 Zod 提供能力。
ts
QuerySchema.parse(input)作用:
- 校验外部输入
- 校验 LLM 输出
- 校验跨模块数据流
这一层是整个系统中最关键的一层,因为它解决的是“数据不可信”的问题
json schame :描述一个json应该有什么字段
2-3. 单元测试
基于 Vitest,对确定性逻辑进行验证。
适用于:
- 工具函数
- chunk 切分逻辑
- metadata 处理逻辑
- pipeline 中的纯函数部分
不适用于:
- LLM 输出(不可预测)
- 外部 API(不稳定)
2-4. 最小示例验证
这一层是很多项目忽略,但在这里非常重要的一层。
每个包都必须提供一个最小可运行示例:
ts
demo/run-xxx.ts例如:
ts
indexing → demo/run-indexing.ts
runtime → demo/run-runtime.ts
作用:
- 验证“这个包是否真的能用”
- 验证默认配置是否合理
- 验证开发体验(DX)
可以理解为:Demo = 最小使用说明 + 可执行验证
2-5. 集成测试
这一层用于验证:多个包是否能协同工作
例如:
ts
indexing → runtime
adapter → indexing
adapter → runtime
验证的是:
- 数据是否能正确流动
- 契约是否一致
- 系统是否闭环
2-6. 两个概念
在这里,有两个非常重要的概念需要明确区分:验证体系 ≠ 指标评估
| 类型 | 作用 |
|---|---|
| 验证体系 | 保证代码正确、系统可运行 |
| 评测体系 | 衡量效果(如召回率、准确率) |
在工程中的落地方式
在实际项目中,我们会约定统一的命令:
json
{
  "scripts": {
    "typecheck": "pnpm -r exec tsc --noEmit",
    "test": "vitest run",
    "check": "typecheck + test",
    "demo": "运行 demo",
    "verify": "check + demo"
  }
}
每个包的最低要求
在这个 RAG SDK 中,我们约定每个包必须具备:
- 类型检查(tsc)
- 至少一个 demo
- 必要的单元测试
最后一句话总结一下:这套验证体系的本质,是用“多层约束”,替代“人工信任 AI 代码”。
3. core包设计
接下来要进入具体开发了,首先第一个应该就是 core 包。
core 负责:
- 共享数据模型(Query / Chunk / RAGResponse)
- 数据校验规则(Zod schema)
- 跨包能力接口(Retriever / Generator)
- 通用错误模型(errors)
- 流程抽象(pipeline 类型级定义)
core 不负责:
- 业务实现
- 外部 SDK
- 包内部私有结构
这里会用到最核心的就是 zod.
很多人一开始会觉得:TypeScript 已经有类型系统了,为什么还需要 zod?
在这个项目里,我们面对的不是一个纯前端应用,而是一个:LLM 参与的系统。一旦引入 LLM,就会出现一个本质问题:类型系统只存在于“编译期”,但 LLM 的输出发生在“运行时”。
这也是为什么需要 Zod 的原因。
在 RAG SDK 这样的系统中,数据的来源不再完全可控:
- 用户输入(自然语言)
- LLM 输出(不稳定结构)
- 外部数据源(文档 / API / DB)
这些数据有一个共同特点:结构不可信
如果只依赖 TypeScript:
ts
type Query = {
  query: string
}
那么在编译期是安全的,但是在运行时完全没有校验。
使用 Zod:
ts
const QuerySchema = z.object({
  query: z.string().min(1)
})
我们就能得到:
- 运行时校验能力
- 明确的错误信息
- 可推导的 TypeScript 类型
在这个架构里,我们约定:Zod 是“唯一数据规则源”(Single Source of Truth)
也就是说:
- schema 定义结构
- type 由 schema 推导
示例:
ts
export const ChunkSchema = z.object({
  id: z.string(),
  content: z.string(),
  metadata: z.record(z.any()).optional()
})

export type Chunk = z.infer<typeof ChunkSchema>
这样带来的好处是:
- 避免类型和校验规则不一致
- 避免“类型改了但校验没改”
- AI 生成代码时有明确约束
Zod 在整个系统中的作用
可以从三个层面理解:
- 用户输入 / 外部数据 → 必须校验,例如:
QuerySchema.parse(input) - 模块边界(Module Boundary),例如:
indexing → runtime、adapter → core,所有跨包数据流,都必须经过 schema,防止“隐式结构错误” - LLM 输出约束(最关键):在后续 runtime 中 LLM 输出 JSON,此时 Zod 作用是 把“不可靠输出”转成“可验证结构”
一个非常关键的设计理念
在这个项目中,我们会遵循:“结构优先,而不是字符串优先”
- 传统做法:LLM 输出一段文本 → 人类解析
- 而在这里:LLM 输出结构化数据 → Zod 校验 → 系统消费
这就类似于我们在做 Web 开发的时候,前后端先定义好接口,后续都按照定义好的接口走。
稳定的结构,带来的是:
- 稳定性
- 可解释性
- 可维护性
因此,Zod 在这个项目中不是一个“工具库”,而是整个 RAG SDK 的“数据约束引擎”。它负责把“不确定的世界(LLM / 外部输入)”转化为“确定的系统输入(结构化数据)”。
后面我们会去写 indexing / runtime / adapters 这些包,而所有数据流动,都围绕 core 中的 schema 展开。
markdown
提示词记录
@安装包  我们现在是monorepo结构,会涉及到一些包装在项目根目录,方便各个包共享,但是一些依赖是装在自己当前包下面。你仔细阅读我上传的文档,看一下这个安装包的建议是否合理

很好,接下来我就需要你将“安装包建议"沉淀到文档里面,方便指导后期i的行为

缺了一条对话

接下来我需要你把这篇“验证体系需求文档”,结合当前仓库的情况,落地一版文档出来,用于指导A后续的行为

请先仔细阅读该文档,然后结合我们项目目前的情况,看一下这份cor包的设计是否合理

接下来,我需要你针对co包的实现,落地一版详细的实施方案,方便指导后期的实际开发工作

接下来请你基我们现在讨论的方案,给出一个详细的实施方案,实施方案以todolist的形式来呈现!
防止ai偷懒减少测试用例
当前我们core包已经做了一部分单元测试用例,我需要你给我一个liist列表,详细罗列出当前做了哪些测试用例,另外你还推荐添加哪些目前没有执行的测试用例
-EOF-